Cómo mejorar tus métricas en el Spark Driver
El Spark Driver es el proceso que orquesta toda la ejecución de tu aplicación: planifica el DAG, coordina los executors, gestiona el shuffle y expone las métricas que usas para diagnosticar problemas. Mejorar sus métricas no significa solo "que corra más rápido", sino reducir tiempos de stage, minimizar el GC, equilibrar el shuffle y lograr que el driver no se convierta en cuello de botella. A continuación, un recorrido completo por las palancas de optimización.
1. Memoria del driver y de los executors. Uno de los problemas más comunes es que el driver se queda corto de memoria al recolectar resultados (collect, take) o al gestionar un DAG muy grande. Aumenta spark.driver.memory si ves OutOfMemoryError: Java heap space en el log del driver. En los executors, ajusta spark.executor.memory y spark.memory.fraction (por defecto 0.6) para dejar espacio suficiente a la memoria ejecutada (execution) frente a la memoria de storage (cache/broadcast).
2. Particionado del shuffle. La métrica que más impacto tiene en el tiempo total de un job es el shuffle. Si tu job tiene, por ejemplo, 500 tareas y un shuffle intermedio genera 200 particiones por tarea, estás creando 100.000 archivos pequeños en disco. Reduce spark.sql.shuffle.partitions (por defecto 200) a un valor proporcional al tamaño de datos objetivo (128-256 MB por partición es la regla general). También puedes forzar reparticiones explícitas con repartition() o coalesce() antes del punto de shuffle.
3. Compresión y serialización Kryo. Activa spark.sql.shuffle.compression (por defecto true) y registra Kryo: spark.serializer = org.apache.spark.serializer.KryoSerializer. Esto reduce drásticamente el volumen de bytes en shuffle y en la red, lo que se traduce directamente en menos tiempo de I/O y menos presión sobre la memoria del driver al transferir metadatos.
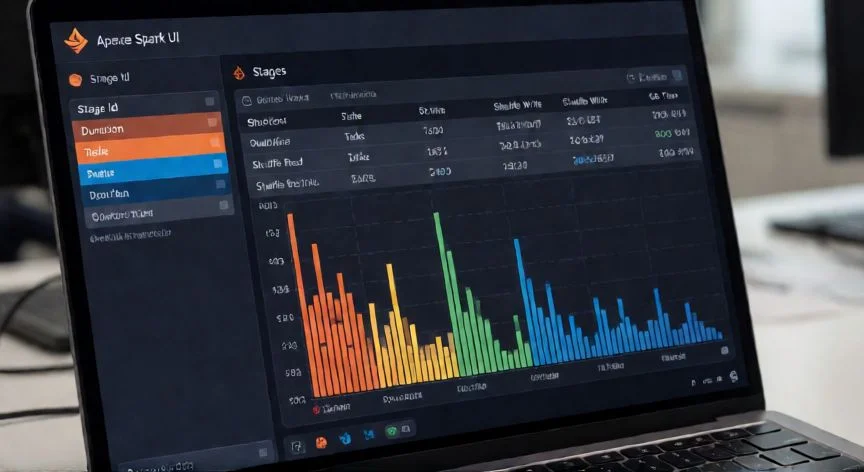
4. Evitar data skew. Un task que tarda 10 veces más que el resto del stage es señal de sesgo en los datos. En el Spark UI, la métrica Task Time por partición lo muestra claramente. Soluciones: salar (agregar una clave aleatoria), usar repartition con más particiones, o reescribir la query para que el join se resuelva con un broadcast join (BroadcastHint) cuando una de las tablas cabe en memoria (por defecto hasta 10 GB con spark.sql.autoBroadcastJoinThreshold).
5. Checkpointing y especulativa. Para DAGs con muchas etapas de shuffle, llama a RDD.checkpoint() o activa spark.sql.hive.executionEngine.sparkHiveCompatible para que Spark materialice intermedios en HDFS/S3. Activa la ejecución especulativa (spark.speculation = true) para que el driver lance tareas duplicadas en executors lentos, reduciendo el stage time percibido.
6. Reducir la presión de GC en el driver. Si usas Java 8, cambia a G1GC: -XX:+UseG1GC -XX:MaxGCPauseMillis=200. En Java 11+, G1 es el default. Evita recolectar datos masivos al driver; en su lugar, escribe en HDFS o usa acciones ligeras como count() o take(10) para validación.
7. Monitorización con JMX y Prometheus. Activa las métricas expuestas por el driver con spark.metrics.namespace = miapp y spark.metrics.conf apuntando a un properties que defina un reporte jmx. Con spark-metrics o prometheus-spark-exporter, puedes graficar en tiempo real: Shuffle Read/Write, Tasks Failed, GC Time, Active Tasks y Shuffle Spill. Esto te da visibilidad para iterar sin adivinar.
8. Optimización a nivel de código. Evita UDFs en Python (pandas-UDF son ~5x más lentas que UDF clásicas); prefiere funciones nativas del DataFrame API (withColumn, when). Minimiza el número de actions (collect, save) y agrupa transformaciones para que el planificador de Catalyst combine etapas. Usa explanation() sobre un DataFrame para inspeccionar el plan físico y detectar joins ineficientes o reparticiones innecesarias.
9. Configuración del shuffle en disco. Si tus executors están en discos SSD, asegúrate de que spark.local.dir apunta a ellos. En entornos con memoria de almacenamiento (NVMe), activa spark.memory.offHeap.enabled = true y asigna spark.memory.offHeap.size para que el shuffle se desborde a memoria en vez de disco, reduciendo la métrica de Shuffle Spill (Disk/Memory).
La regla de oro del particionado: apunta a 128-256 MB por partición en shuffle; menos = skew, más = overhead de I/O.
Dato clave