
INICIO
educacion · matematicas
como encontrar z en la tabla de distribucion normal, Tabla Z impresa con la celda Φ(1,96)=0,9750 señalada y curva normal dibujada a mano
educacion ·#7593 ·Lectura 7 min. · Redactor: Cati Ariza

📊 Cómo encontrar Z en la tabla de distribución normal

Respuesta corta
Verificado
Redactado por Humanos!

Z = (x – μ) / σ es la fórmula de tipificación obligatoria antes de leer cualquier tabla Z. La tabla solo funciona para la normal estándar N(0,1).

01

Cómo encontrar Z en la tabla de distribución normal: guía práctica completa

La tabla Z es una herramienta fundamental en estadística porque conecta una puntuación estándar con el área bajo la curva de la distribución normal. Lo esencial que hay que tener claro desde el principio es que cada celda entrega el área acumulada a la izquierda del valor Z, es decir, la probabilidad de obtener un dato menor o igual a esa puntuación. Se escribe como P(Z ≤ z) = valor de la tabla. Y eso, en la práctica, significa que el número que buscas no es una altura, no es una densidad, sino un porcentaje de datos que queda por debajo del punto marcado.


Un puntaje Z simplemente te dice cuántas desviaciones estándar se separa un valor concreto de la media de toda la distribución. La fórmula es directa: Z = (x – μ) / σ. Si el resultado es positivo, el dato está por encima de la media; si es negativo, está por debajo. No tiene más misterio que eso, pero es el punto de partida obligatorio antes de tocar la tabla, porque la tabla está diseñada exclusivamente para la normal estándar con media 0 y desviación 1.


La estructura física de la tabla es lo que marca la diferencia entre encontrar el valor o perderte buscando. La primera columna contiene la parte entera y el primer decimal de z. La cabecera superior aporta el segundo decimal. La celda donde ambos se cruzan es tu resultado. Así, para localizar z = 1,96 buscas la fila 1,9 y la columna ,06, y en la intersección aparece Φ(1,96) = 0,9750. Eso quiere decir que el 97,50 % del área bajo la curva queda a la izquierda de 1,96.


El procedimiento paso a paso siempre es el mismo. Supongamos que necesitas P(Z ≤ −1,53). Primero descompones: −1,53 = −1,5 + 0,03. Buscas −1,5 en la primera columna, luego 0,03 en la fila superior, y la celda de cruce te da la respuesta: P(Z ≤ −1,53) = 0,0630. Con z = −0,72 haces exactamente lo mismo: fila −0,7, columna 0,02, resultado 0,2360. No hay atajos, no hay fórmulas mágicas, es geometría de tabla.


Ahora bien, si tu variable no es estándar, el primer movimiento obligatorio es tipificar. Si X sigue una normal con media μ y desviación σ, calculas z = (x − μ) / σ y solo entonces entras a la tabla. Por ejemplo, con μ = 100 y σ = 15, para P(X ≤ 120) haces: z = (120 − 100)/15 ≈ 1,33. Y en la tabla, P(Z ≤ 1,33) = 0,9082. Sin esa conversión previa, la tabla simplemente no aplica, está pensada para la N(0,1) y nada más.


Un caso aplicado que lo ilustra perfectamente: los puntajes de un examen de ingreso se distribuyen con media μ = 82 y desviación σ = 8. Quieres saber qué porcentaje obtiene menos de 84. Primero, z = (84 − 82)/8 = 0,25. Buscas 0,25 en la tabla y obtienes que aproximadamente el 59,87 % de los estudiantes sacan menos de 84. El segundo ejemplo usa la cola derecha: la altura de ciertas plantas tiene media 26,5 pulgadas y σ = 2,5. Para z = (26 − 26,5)/2,5 = −0,2, la tabla dice que el 42,07 % cae por debajo. Como lo que se pide son los valores mayores, restas: 100 % − 42,07 % = 57,93 %.


Cuando necesitas la probabilidad de un valor entre dos cotas, calculas las dos puntuaciones Z y restas las áreas. Con el peso de una especie de delfín (μ = 400 libras, σ = 25), para el rango 410-425: z(410) = 0,4 y z(425) = 1. La tabla da 0,8413 y 0,6554. La resta: 0,8413 − 0,6554 = 0,1859, es decir, cerca del 18,59 % pesa en ese intervalo. Fíjate que siempre trabajas con áreas acumuladas, nunca con alturas de la curva.


Hay que tener muy presente una advertencia que confunde a mucha gente: las tablas de densidad muestran una altura, no un área ni una probabilidad. La densidad f(z) = (1/√(2π))·e−z²/2 tiene máximo f(0) = 0,3989, pero eso no es una probabilidad puntual. Para obtener probabilidades reales necesitas integrar, y eso es exactamente lo que la tabla acumulada ya hace por ti, evitando la integración manual. La función Φ(z) = P(Z ≤ z) no tiene expresión cerrada, y esa es precisamente la razón de existir de estas tablas.


Para verificar rápidamente si tu lectura es correcta, memoriza estos valores de referencia: Z = 0 → 0,5000 (la media divide la distribución en dos mitades), Z = 1 → 0,8413, Z = −1 → 0,1587, Z = 2 → 0,9772 y Z = −2 → 0,0228. Estos números se apoyan en la famosa regla 68-95-99,7: el 68 % de los datos está dentro de una desviación, el 95 % dentro de dos y el 99,7 % dentro de tres.


La conversión entre tabla y porcentaje es directa y no tiene trampa: valor de la tabla × 100 = porcentaje. Así, 0,0630 se lee como 6,30 %, 0,2360 como 23,60 %, 0,8413 como 84,13 %. Y un último apunte práctico: si el valor exacto no aparece en la tabla, tomas el más cercano y reconstruyes Z con su fila y columna. Para mayor precisión, usa calculadoras de distribución normal que evitan el redondeo a dos decimales.

“Para hallar Z a partir de un área: busca el valor numérico en el cuerpo de la tabla y lee su fila (entero + 1er decimal) y columna (2º decimal). Para colas derechas, usa Φ(−z) = 1 − Φ(z).”

Dato clave
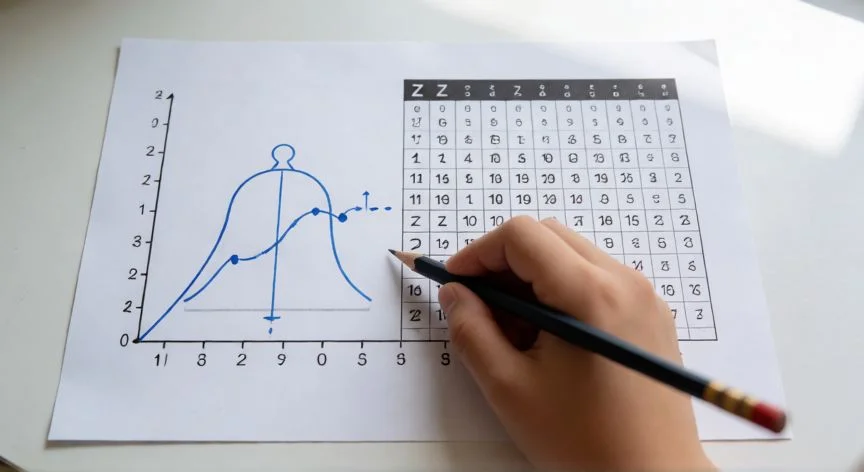
como encontrar z en la tabla de distribucion normal, Estudiante resolviendo un problema de distribución normal con fórmula tipificada y tabla Z
Imagen

Estudiante resolviendo un problema de distribución normal con fórmula tipificada y tabla Z

02

De la lectura directa a la operación inversa: todo lo que necesitas saber sobre la tabla Z

Los tres tipos de problema que aparecen una y otra vez en ejercicios y exámenes se resuelven todos con un único dato: el área a la izquierda. P(Z ≤ z) se lee directamente. P(Z > z) se obtiene restando de 1, porque el área total bajo la curva es 1. Y P(a < Z < b) = Φ(b) − Φ(a). Ejemplos concretos: P(Z > 1,25) = 1 − 0,8944 = 0,1056, y P(−0,50 < Z < 1,50) = 0,9332 − 0,3085 = 0,6247. Cuatro términos son equivalentes en este contexto: área, porcentaje, probabilidad y posibilidad. No te enredes con las palabras.


La operación inversa, encontrar Z a partir de una probabilidad, es la que más errores produce porque se hace exactamente al revés. No entras por fila y columna, sino que buscas el valor de probabilidad dentro del cuerpo de la tabla y luego reconstruyes Z uniendo la etiqueta de fila donde aparece con la de su columna. Si quieres el Z que deja el 77 % acumulado, conviertes a 0,77, localizas ese número en la tabla y lees Z ≈ 0,74. Si te dan el porcentaje mayor, primero conviertes al complementario: 100 % − 33 % = 67 %, buscas 0,67 y obtienes Z ≈ 0,44.


Ese mecanismo inverso es el que genera los valores críticos usados en intervalos de confianza. Para un intervalo bilateral del 95 % buscas el valor que deja 97,5 % acumulado: Φ(z) = 0,975 corresponde a z = 1,96. Para el 99 %, el acumulado 0,995 da z = 2,576. Estos percentiles clave conviene tenerlos memorizados porque aparecen en casi cualquier prueba de hipótesis o estimación:


PercentilValor Z
z₀.₉₀1,282
z₀.₉₅1,645
z₀.₉₇₅1,960
z₀.₉₉2,326
z₀.₉₉₅2,576

La tabla también sirve para determinar cuartiles y percentiles de un conjunto de datos que sigue una distribución normal. El primer cuartil Q1 corresponde a un área acumulada de 0,25; buscando en la tabla encuentras que Z ≈ −0,675, lo que significa que el primer cuartil está unas 0,675 desviaciones estándar por debajo de la media. Es un recurso muy útil en descripciones de datos donde no tienes la muestra completa pero sabes que se comporta como una normal.


En el terreno de la inferencia estadística, la tabla Z se usa para determinar el valor p, que indica la probabilidad de observar una estadística tan extrema como la obtenida bajo la hipótesis nula. Pero su alcance va mucho más allá de un examen universitario. En control de calidad se emplea para entender la variación en procesos de manufactura, en medicina para analizar resultados de pruebas diagnósticas y en psicometría para interpretar puntajes de test psicológicos.


La distribución normal, también llamada gaussiana, es una de las más importantes en estadística porque una enorme cantidad de fenómenos naturales y errores de medida siguen esta forma. El uso de la tabla Z permite convertir cualquier distribución normal en una estándar, lo cual es crucial para hacer comparaciones entre poblaciones distintas o evaluar resultados en campos como la psicología, la educación o la economía.


Un último consejo práctico que marca la diferencia entre el error clásico y la lectura correcta: dibuja siempre la curva normal y sombrea la zona que te piden. Eso evita confundir la cola izquierda con la derecha, que es probablemente el fallo más frecuente en ejercicios de tabla Z. Practica manipulando valores y áreas acumuladas con regularidad, apóyate en recursos en línea para verificar resultados y ten presente que la simetría Φ(−z) = 1 − Φ(z) te ahorra buscar en la mitad negativa de la tabla cada vez.


La función de distribución acumulada no se puede expresar con una fórmula cerrada sencilla, y esa es la razón por la que las tablas existen desde hace más de un siglo. Antes de las calculadoras, la tabla era la única vía; hoy sigue siendo una herramienta de referencia rápida que, bien leída, resuelve en segundos lo que un software tardaría apenas un instante en resolver, pero que tú no siempre vas a tener a mano en un examen o en el terreno.

Conclusión:

¿como encontrar z en la tabla de distribucion normal?

Encontrar Z en la tabla no es un truco, es una lectura geométrica: fila por un lado, columna por otro, y el cruce te da la probabilidad acumulada. Lo que sí cambia radicalmente cuando vas al revés, buscando Z a partir de un porcentaje, es que tienes que meterte dentro del cuerpo de la tabla como quien busca una palabra en un diccionario. Yo creo que el punto donde más gente se atasca no es la lectura directa, sino esa operación inversa combinada con decidir si te piden la cola izquierda o la derecha. Dibuja la curva, sombrea la zona y la tabla deja de ser un muro de números para convertirse en algo bastante intuitivo. Y sí, es complicado dar una sola respuesta sobre qué método usar para cada caso, porque depende de si te dan el dato crudo o la probabilidad, pero con práctica los dos flujos se vuelven automáticos.

Redacción: Cati Ariza · Actualizado en: 09/11/2026
Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta Valoración para Respuesta
3.9 / 5 · 53 valoraciones Valorar

¿Tienes algo que aportar? Envíanos tu respuesta

Mis métodos favoritos para numerar filas en Excel sin que se rompa nada Mis métodos favoritos para numerar filas en Excel sin que se rompa nada