Por qué Google Gemini no generaba imágenes (y cuándo empezó a hacerlo)
La duda es completamente legítima: si Gemini puede entender imágenes, vídeos y audio con gran precisión, ¿por qué durante mucho tiempo no fue capaz de crear una imagen a partir de un prompt? La respuesta corta es que la comprensión y la generación visual son problemas arquitectónicos fundamentally distintos, y Google decidió abordarlos con modelos separados durante sus primeras iteraciones.
Gemini, en sus versiones 1.0 y 1.5, fue diseñado como un modelo multimodal de comprensión. Su arquitectura tipo Transformer autoregresivo excela en procesar secuencias de tokens, ya sean texto, patchs de imagen o frames de vídeo, y producir como salida una secuencia de texto. Entender una imagen significa dividirla en tokens visuales y razonar sobre ellos; generar una imagen, en cambio, exige un mecanismo muy distinto, generalmente un modelo de difusión (diffusion model) que parte de ruido aleatorio y lo va refinando paso a paso hasta formar la imagen.
En el ecosistema de Google, esa labor de generación visual recaía sobre un modelo independiente llamado Imagen. Imagen 1, 2 y 3 son modelos de difusión entrenados específicamente para crear píxeles coherentes a partir de descripciones textuales. Mientras Gemini 'leía' el mundo visual, Imagen lo 'pintaba'. Esta separación permitía a cada equipo optimizar su modelo para una tarea concreta sin comprometer la eficiencia del otro.
Además existió una decisión estratégica de producto: Google quería que Gemini fuera el 'cerebro' razonador (planificación, código, análisis) y que las herramientas de creación visual fueran accesibles a través de interfaces como Imagen Playground o integraciones en Google Photos y Android. Mezclar ambas funciones en un único endpoint hubiera complicado la latencia, los costos de cómputa y la moderación de contenido generado.
Un segundo factor es la complejidad computacional. Un modelo de difusión requiere decenas de pasos de denoising por imagen, cada uno con una red neuronal pesada. Añadir esa carga dentro de la misma inferencia autoregresiva de Gemini habría disparado los tiempos de respuesta de forma inaceptable para un asistente conversacional que espera responder en segundos.
La situación empezó a cambiar con Gemini 2.0 Flash (mediados de 2024), donde Google incorporó de forma experimental la capacidad de generar imágenes directamente dentro de la conversación. En la práctica, el modelo LLM traducía el prompt del usuario y lo pasaba al motor Imagen 'por debajo', devolviendo la imagen al chat. No era que el Transformer generara píxeles, sino que actuaba como orquestador entre el lenguaje y el difusor.
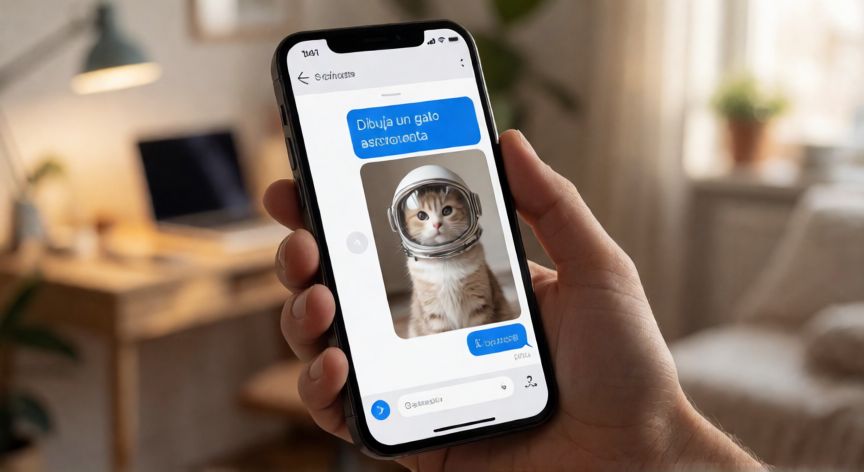
Con Gemini 2.5 (2025) la integración se hizo más transparente y fluida: el usuario puede pedir 'dibuja un gato vestido de astronauta' y recibir la imagen en el mismo hilo, sin cambiar de herramienta. Aun así, bajo el capó sigue operando una arquitectura de difusión acoplada, no una generación autoregresiva nativa de píxeles por parte del LLM.
En resumen, Gemini 'no generaba imágenes' porque su arquitectura original no estaba diseñada para ello, y Google prefirió mantener la separación entre razonamiento (Gemini) y síntesis visual (Imagen) hasta que la ingeniería permitiera acoplarlos sin penalizar la experiencia de usuario.
Hoy, si usas Gemini en el sitio web o en la app y no ves la opción de imagen, puede deberse a que tu plan (gratuito vs. Pro/Ultra) limita las funciones multimodales de salida, a la región desde la que accedes, o a que estás usando una API con un endpoint que solo expone la capacidad de texto. Revisa la documentación de Google AI Studio para confirmar qué capacidades tiene habilitadas tu clave.
Desde Gemini 2.5, la generación de imágenes está integrada nativamente en el chat, aunque bajo el capó sigue usando un difusor acoplado.
Dato clave