Instagram

¿Qué fórmula NAN es mejor? Las dos preguntas que esconde esta duda
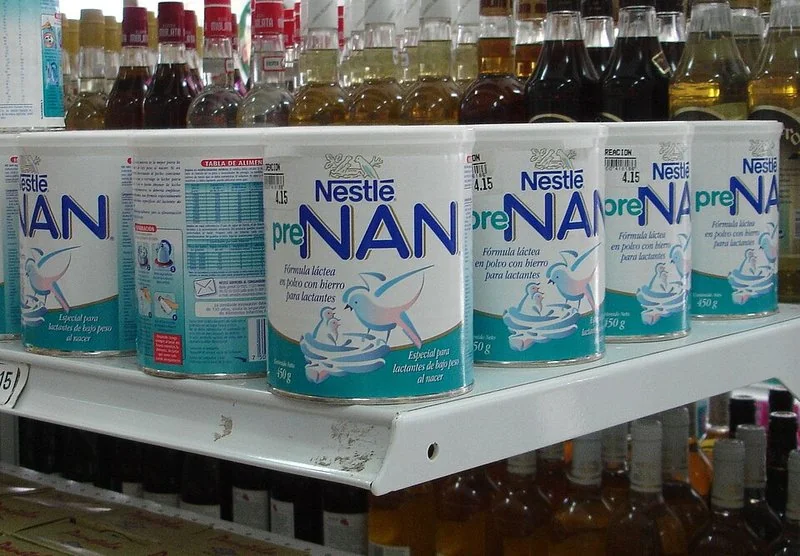
La expresión "fórmula NAN" puede referirse a dos mundos completamente distintos, y conviene aclarar cuál te interesa antes de entrar en materia. En el terreno del dato (Python, NumPy, Pandas), NaN es el valor especial "Not a Number" definido por el estándar IEEE 754, y la pregunta se traduce en: ¿qué función detecta mejor esos valores? En la puericultura, NAN es la marca de leches de fórmula de Nestlé, y la duda es qué variante de la gama conviene.
Empecemos por el mundo del código. NaN aparece constantemente en ciencia de datos, cálculo numérico y machine learning cuando los conjuntos de datos arrastran valores perdidos, indefinidos o inválidos. No detectarlos a tiempo puede corromper un modelo entero, así que elegir bien la función de comprobación no es un capricho, es una necesidad práctica.
Existen tres vías principales para identificar NaN en Python, y cada una brilla en un contexto concreto. La tabla siguiente resume las diferencias clave:
| Función | Ámbito ideal | Limitación principal |
|---|---|---|
| math.isnan(x) | Un único escalar float | No admite cadenas, None ni objetos genéricos |
| numpy.isnan() | Arrays numéricos puros | Lanza TypeError con tipos no numéricos |
| pd.isna() / isnull() | Datos mixtos, Series, DataFrames | Ninguna relevante para uso habitual |
math.isnan() es la más minimalista. Su sintaxis es un solo parámetro, está disponible desde Python 3.5 y devuelve True o False. Pero se queda corta enseguida: si intentas pasarlé una cadena o un None, el programa se rompe. Útil cuando sabes que estás ante un único float, nada más.
numpy.isnan() da un salto hacia lo vectorizado. Aplicada sobre un array devuelve un array booleano del mismo tamaño con True donde hay NaN. El problema llega con los datos heterogéneos: mezcla una columna con números y una cadena, y te saltará un "Not implemented for this type" que interrumpe todo el preprocesado.
pd.isna(), en cambio, es la opción que la propia documentación de Pandas recomienda en versiones recientes. Es independiente del tipo de dato: detecta NaN numérico, None, NaT (Not a Time), cadenas vacías y objetos genéricos sin generar excepciones. Una Serie que mezcla 'manzana', np.nan y 'plátano' se resuelve con una sola llamada sin drama.
Además, pd.isna() implementa código C optimizado a nivel subyacente, así que rinde mejor que soluciones basadas en try/except. Para DataFrames grandes se recomienda usar df.isna() sobre todas las columnas a la vez, aprovechando el vectorizado natural de Pandas.
Como patrón híbrido para escenarios muy exigentes, se documenta una función que comprueba el tipo primero: si es int, float o complex usa np.isnan(); en cualquier otro caso delega en pd.isna(). Es un truco útil pero innecesario en el 95% de los casos reales.
La regla práctica es sencilla: array numérico puro → np.isnan(); un escalar float → math.isnan(); todo lo demás → pd.isna(). Y si dudas, pd.isna() nunca falla por tipo.
“NAN Supreme Pro 1 incluye 6 HMOs + OPTIPRO HA parcialmente hidrolizada + Dual Probiotics: la fórmula más completa de Nestlé.”
Dato clave